
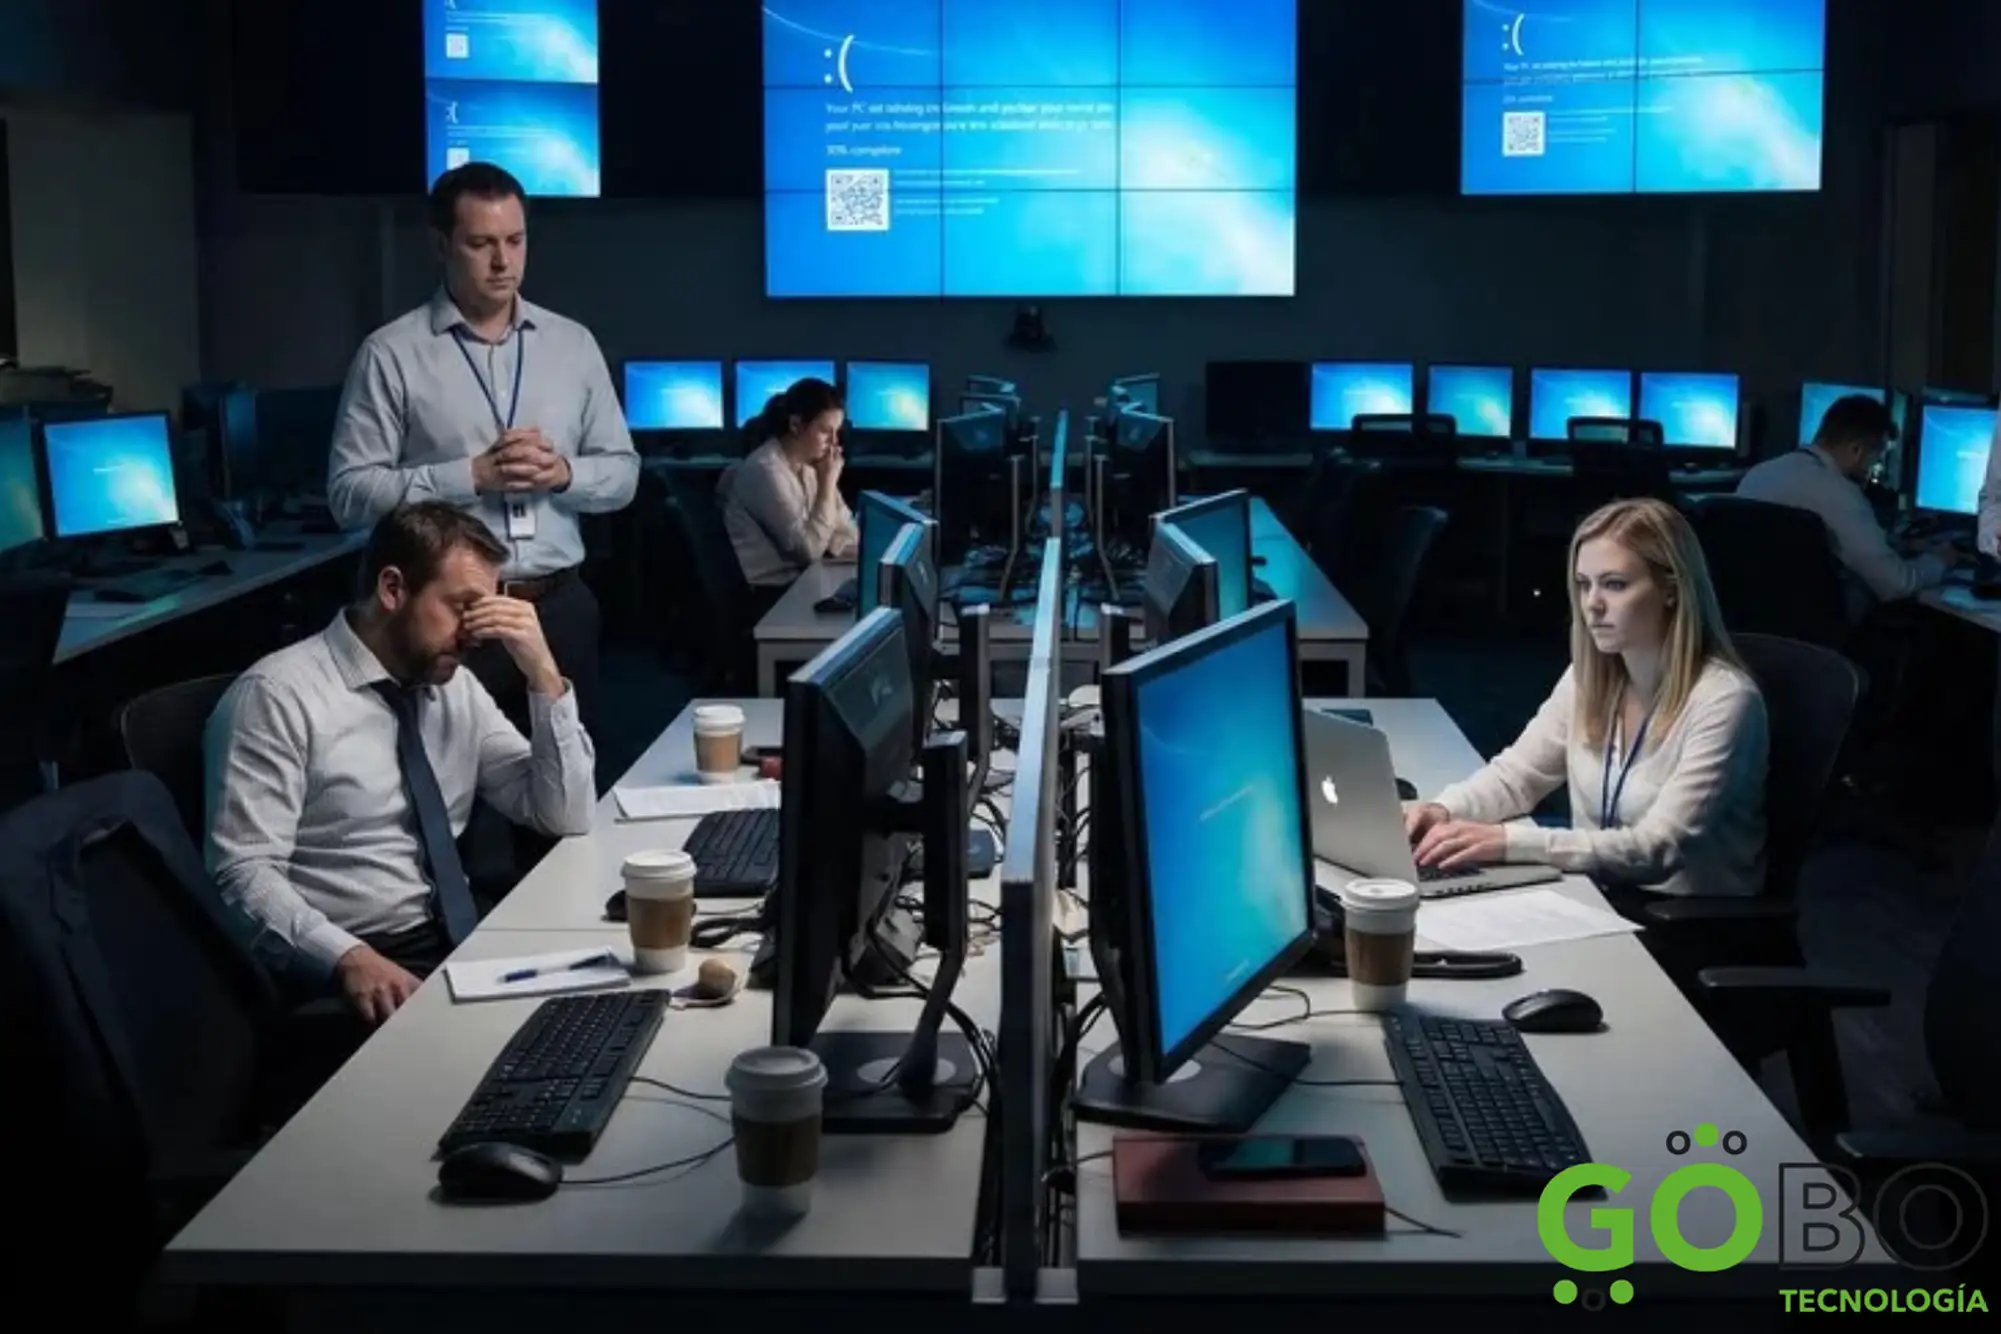
Durante años, los expertos advirtieron que la dependencia tecnológica total de las empresas podría convertirse en su mayor vulnerabilidad.
Parecía una exageración, sin embargo, hace poco ocurrió un hecho real que paralizó la infraestructura crítica a nivel mundial y sorprendió a toda la industria tecnológica. La empresa de ciberseguridad CrowdStrike emitió una actualización defectuosa para su plataforma de protección, lo que provocó que millones de computadoras con sistemas Microsoft Windows colapsaran mostrando la temida «pantalla azul de la muerte». Aeropuertos, bancos, hospitales y canales de televisión alrededor del mundo quedaron inoperativos en cuestión de horas.
Aunque este hecho no fue provocado por un grupo de hackers, sí representa una señal de alerta sobre un nuevo desafío: ¿qué sucede cuando las mismas herramientas diseñadas para proteger la red terminan derribando por accidente las operaciones de tu negocio?
La noticia ha generado preocupación en toda la industria tecnológica y motivó reuniones de emergencia en empresas de todos los tamaños para revisar la verdadera resiliencia de su infraestructura de TI.
1. ¿Qué fue exactamente lo que ocurrió?
Todo comenzó durante el despliegue automático de una actualización de rutina en un software de ciberseguridad.
El objetivo era mantener las defensas de los sistemas de grandes corporaciones preparadas contra las últimas amenazas de internet. Sin embargo, un archivo corrupto dentro del parche de CrowdStrike provocó un conflicto fatal en el sistema operativo Windows de Microsoft.
A diferencia de otros errores menores, este fallo impedía que las computadoras pudieran arrancar normalmente, dejándolas atrapadas en un bucle de reinicio infinito que bloqueó el acceso a bases de datos y plataformas.
2. ¿Fue producto de un ciberataque masivo?
Esta es probablemente la pregunta que más personas se hicieron después de conocer la noticia y ver los vuelos cancelados.
La respuesta es no. No existe evidencia de que actores maliciosos intervinieran en los sistemas. Lo que ocurrió fue consecuencia de una falla interna de programación y de una falta de control de calidad antes de liberar la actualización al público.
En otras palabras, la herramienta falló al intentar cumplir su objetivo principal. El problema fue que, al tener un acceso tan profundo en los servidores del mundo, un simple error de código terminó superando las barreras de tolerancia y provocando un efecto dominó devastador.
3. El peligro de depender de un solo entorno
Hasta hace poco, la conversación sobre infraestructura tecnológica se centraba en unificar a todos los equipos bajo un solo proveedor para reducir costos. Ahora el escenario es diferente.
El incidente demostró que tener todos los sistemas críticos dependiendo de un único software crea un punto de falla inmenso. Curiosamente, las infraestructuras que usaban servidores Linux o computadoras Mac no se vieron afectadas.
Eso significa que las empresas deben empezar a diseñar ecosistemas más diversos. El incidente demostró que la seguridad ya no consiste únicamente en tener el mejor antivirus, sino en cómo está diseñada la arquitectura técnica completa de la empresa.
4. CrowdStrike y Microsoft iniciaron las labores de recuperación
Tras el incidente, ambas compañías trabajaron contrarreloj para frenar la actualización y enviar soluciones. Si bien CrowdStrike retiró el parche corrupto rápidamente, el daño en los equipos que ya lo habían descargado requirió medidas drásticas.
Más allá de identificar al responsable, la solución técnica fue un golpe duro a la automatización: debido a que las máquinas no iniciaban, miles de técnicos de TI tuvieron que ir equipo por equipo, encenderlos en «modo seguro» y borrar manualmente el archivo dañado.
Esto reafirmó que el soporte técnico humano, como el que brinda GOBO, sigue siendo irremplazable ante las verdaderas crisis
5. La industria reaccionó inmediatamente
La repercusión fue tan grande que organismos internacionales y empresas comenzaron a discutir nuevos protocolos para evaluar actualizaciones de software crítico antes de su despliegue.
El mensaje fue claro:
La hiperconexión tecnológica está avanzando más rápido que los planes de recuperación de las organizaciones.
Y eso obliga a replantear cómo se respaldan los datos antes de que un error paralice por completo a millones de usuarios.
6. ¿Qué significa esto para las empresas?
Aunque este incidente tuvo origen en laboratorios de gigantes tecnológicos, deja una enseñanza importante para cualquier organización.
Cada vez más empresas dependen de la tecnología para procesos críticos:
- Facturación.
- Ventas online.
- Atención al cliente.
- Logística y despachos.
- Sistemas internos.
A medida que tus operaciones dependen del software, también será necesario fortalecer las copias de seguridad (backups), los protocolos de recuperación ante desastres y la supervisión de expertos en TI.
La digitalización seguirá avanzando, pero deberá hacerlo acompañada de verdaderas prácticas de blindaje tecnológico
7. La próxima gran prioridad ya no será solo migrar a la nube
Durante los últimos años, las empresas tecnológicas compitieron por subir todas sus operaciones a internet lo más rápido posible.
Después de estos incidentes, la competencia podría cambiar.
La pregunta ya no será únicamente:
- ¿Qué tan moderna es mi infraestructura digital?
Sino también:
- ¿Qué tan rápido puede mi negocio volver a operar si el proveedor principal falla de un momento a otro?
La resiliencia y los planes de contingencia podrían convertirse en el principal factor diferenciador de las empresas que sobreviven a la próxima década.
Conclusión
El reciente y caótico apagón global provocado por CrowdStrike y Microsoft no significa que debamos abandonar la digitalización o dejar de confiar en la tecnología.
Lo que realmente muestra es algo igual de importante:
Estamos entrando en una etapa donde la dependencia digital es tan profunda que contar con un soporte técnico especializado, copias de seguridad y sistemas escalables se convierte en una prioridad innegociable.
La tecnología seguirá impulsando el crecimiento corporativo.
La diferencia es que, a partir de ahora, el mundo no sólo medirá qué tan eficiente es tu empresa en un buen día… también qué tan preparada está para recuperarse rápidamente cuando la red global falla.